诡异的 Docker 幽灵端口:明明 lsof 在监听,为什么网页始终无法访问?
文章目录
在日常和服务器打交道的过程中,我们总会遇到一些让人抓狂的”诡异现象”。今天要分享的这个真实排查案例,堪称运维和开发人最容易踩的经典大坑之一:服务全绿、端口在监听、本机访问也正常,但外部浏览器始终无法访问!
这篇文章就用大白话带你复盘一下整个破案过程,顺便扒一扒 Docker 端口映射在 Linux 底层到底干了什么。
一、案发现场:薛定谔的 3000 端口
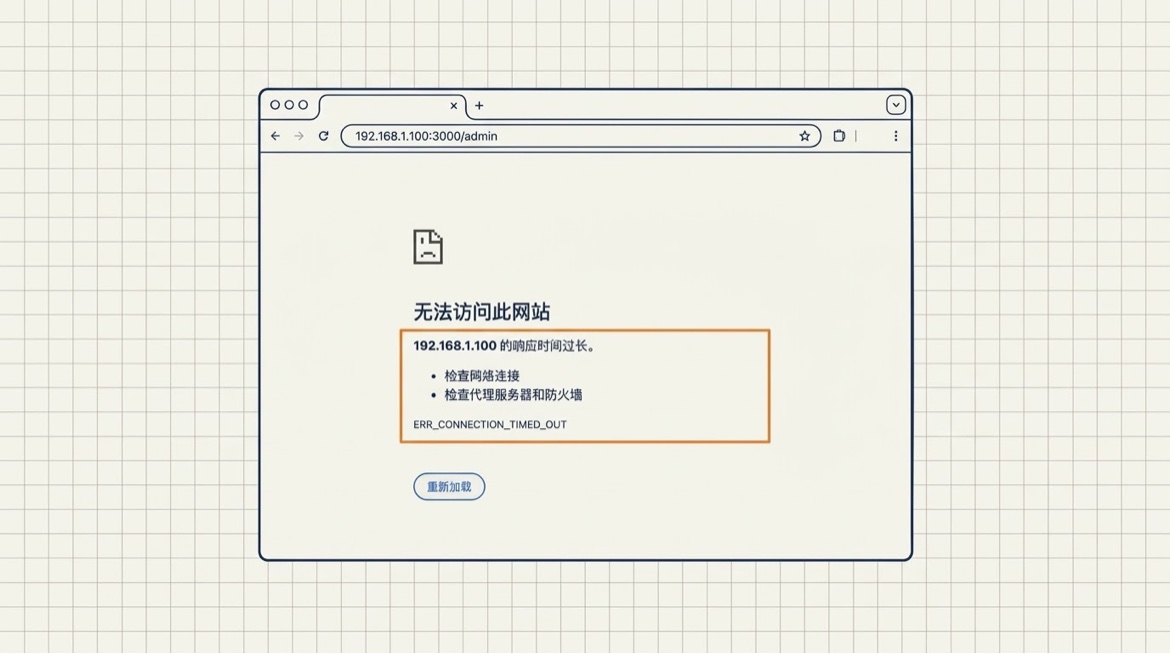
事情的起因很简单:我们在云服务器上用 Docker 部署了一套 Web 服务,把容器的 3000 端口映射到了宿主机上。部署完成后,兴冲冲地打开浏览器输入 http://192.168.1.100:3000/admin(IP 已脱敏),结果迎面泼来一盆冷水:
无法访问此网站
192.168.1.100 的响应时间过长。
ERR_CONNECTION_TIMED_OUT
连不上?第一反应自然是:服务没起来,或者端口没监听吧?
于是赶紧连上服务器终端,一套连招下去,结果让人当场陷入沉思:
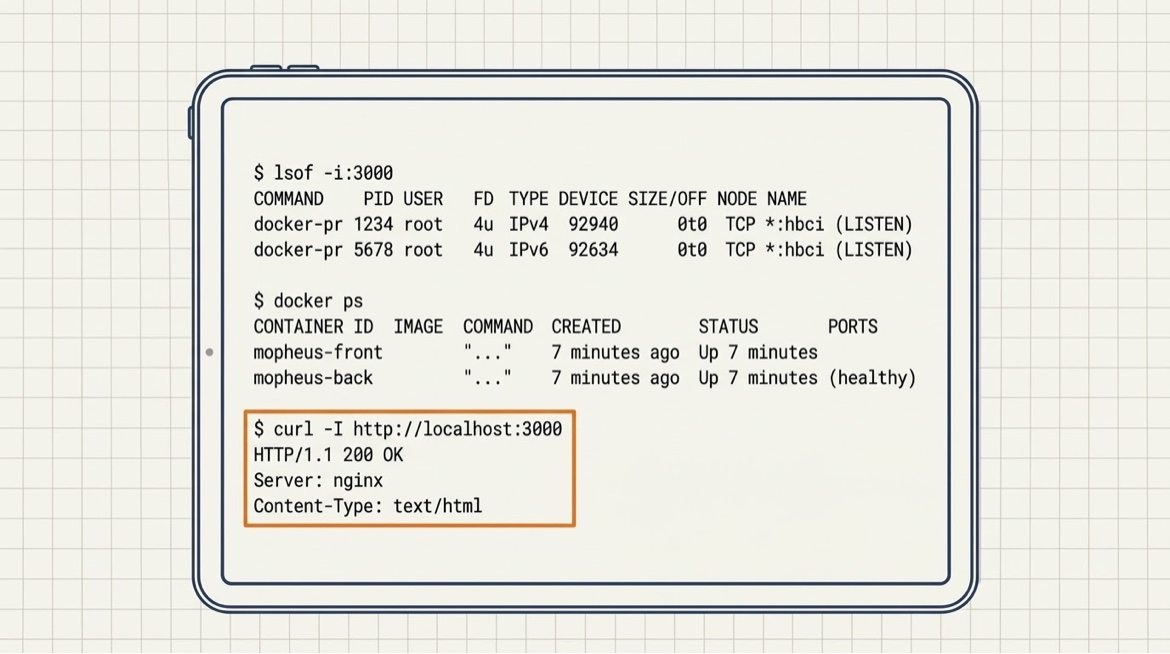
1. 查端口监听:明明开着啊!
1 | $ lsof -i:3000 |
(注:这里的 hbci 只是系统 /etc/services 里给 3000 端口起的默认别名,代表 0.0.0.0:3000 正在正常监听。)
2. 查容器状态:全员健康!
1 | $ docker ps -a --format "{{.Names}} {{.Status}}" |
3. 在服务器本机 curl 一下:秒回 200!
1 | $ curl -s -o /dev/null -w "%{http_code}\n" http://localhost:3000 |
这就很诡异了:容器活得好好的,3000 端口也确确实实在监听,在服务器自己身上访问 localhost:3000 也是秒开。但只要从外部电脑去访问(哪怕用 telnet 192.168.1.100 3000 测试),就如同石沉大海,直接超时!
二、抽丝剥茧:一句话揪出”真凶”
在网络排查中,”连接被拒绝(Connection Refused)”和”连接超时(Connection Timed Out)”有着本质区别:
- 连接被拒绝:数据包到了服务器,服务器明确回了一句”这端口没人管,滚”。
- 连接超时:数据包发出去后直接被半路截杀(丢弃),连个回音都没有。
既然本机 localhost 能通,外部 IP 不通,说明问题一定出在网络转发或防火墙拦截上。在排除了云平台安全组和系统防火墙之后,我们查了一下 Linux 内核的一个关键参数:
1 | $ sysctl net.ipv4.ip_forward |
破案了!罪魁祸首就是这个 0!
我们立刻在终端执行以下命令把它改成 1(开启内核 IPv4 转发):
1 | sysctl -w net.ipv4.ip_forward=1 |
再去浏览器刷新页面,原本无法访问的后台界面,瞬间丝滑加载出来!
三、大白话原理:为什么 Docker 会栽在这个参数上?
很多朋友会纳闷:”我明明访问的是宿主机的 3000 端口,lsof 里也看到 docker-proxy 在宿主机上监听着 3000 端口,为什么还需要开启什么内核路由转发?只有 Docker 会这样吗?”
用大白话给你翻译一下这背后的过程,你就彻底明白了。
1. 容器其实是一台”屋中屋”的独立小电脑
如果你直接在宿主机上装一个 Nginx 或 MySQL,它直接用的是宿主机自己的网卡,门牌号就是宿主机的 IP。外人来敲门,宿主机直接开门迎客,根本不需要”转发”。
但 Docker 默认使用的是 Bridge(桥接)网络模式。你可以把宿主机想象成一栋写字楼(IP 是 192.168.1.100),而 Docker 容器则是写字楼里的独立小隔间,有自己内部局域网的虚拟门牌号(比如 172.17.0.2)。
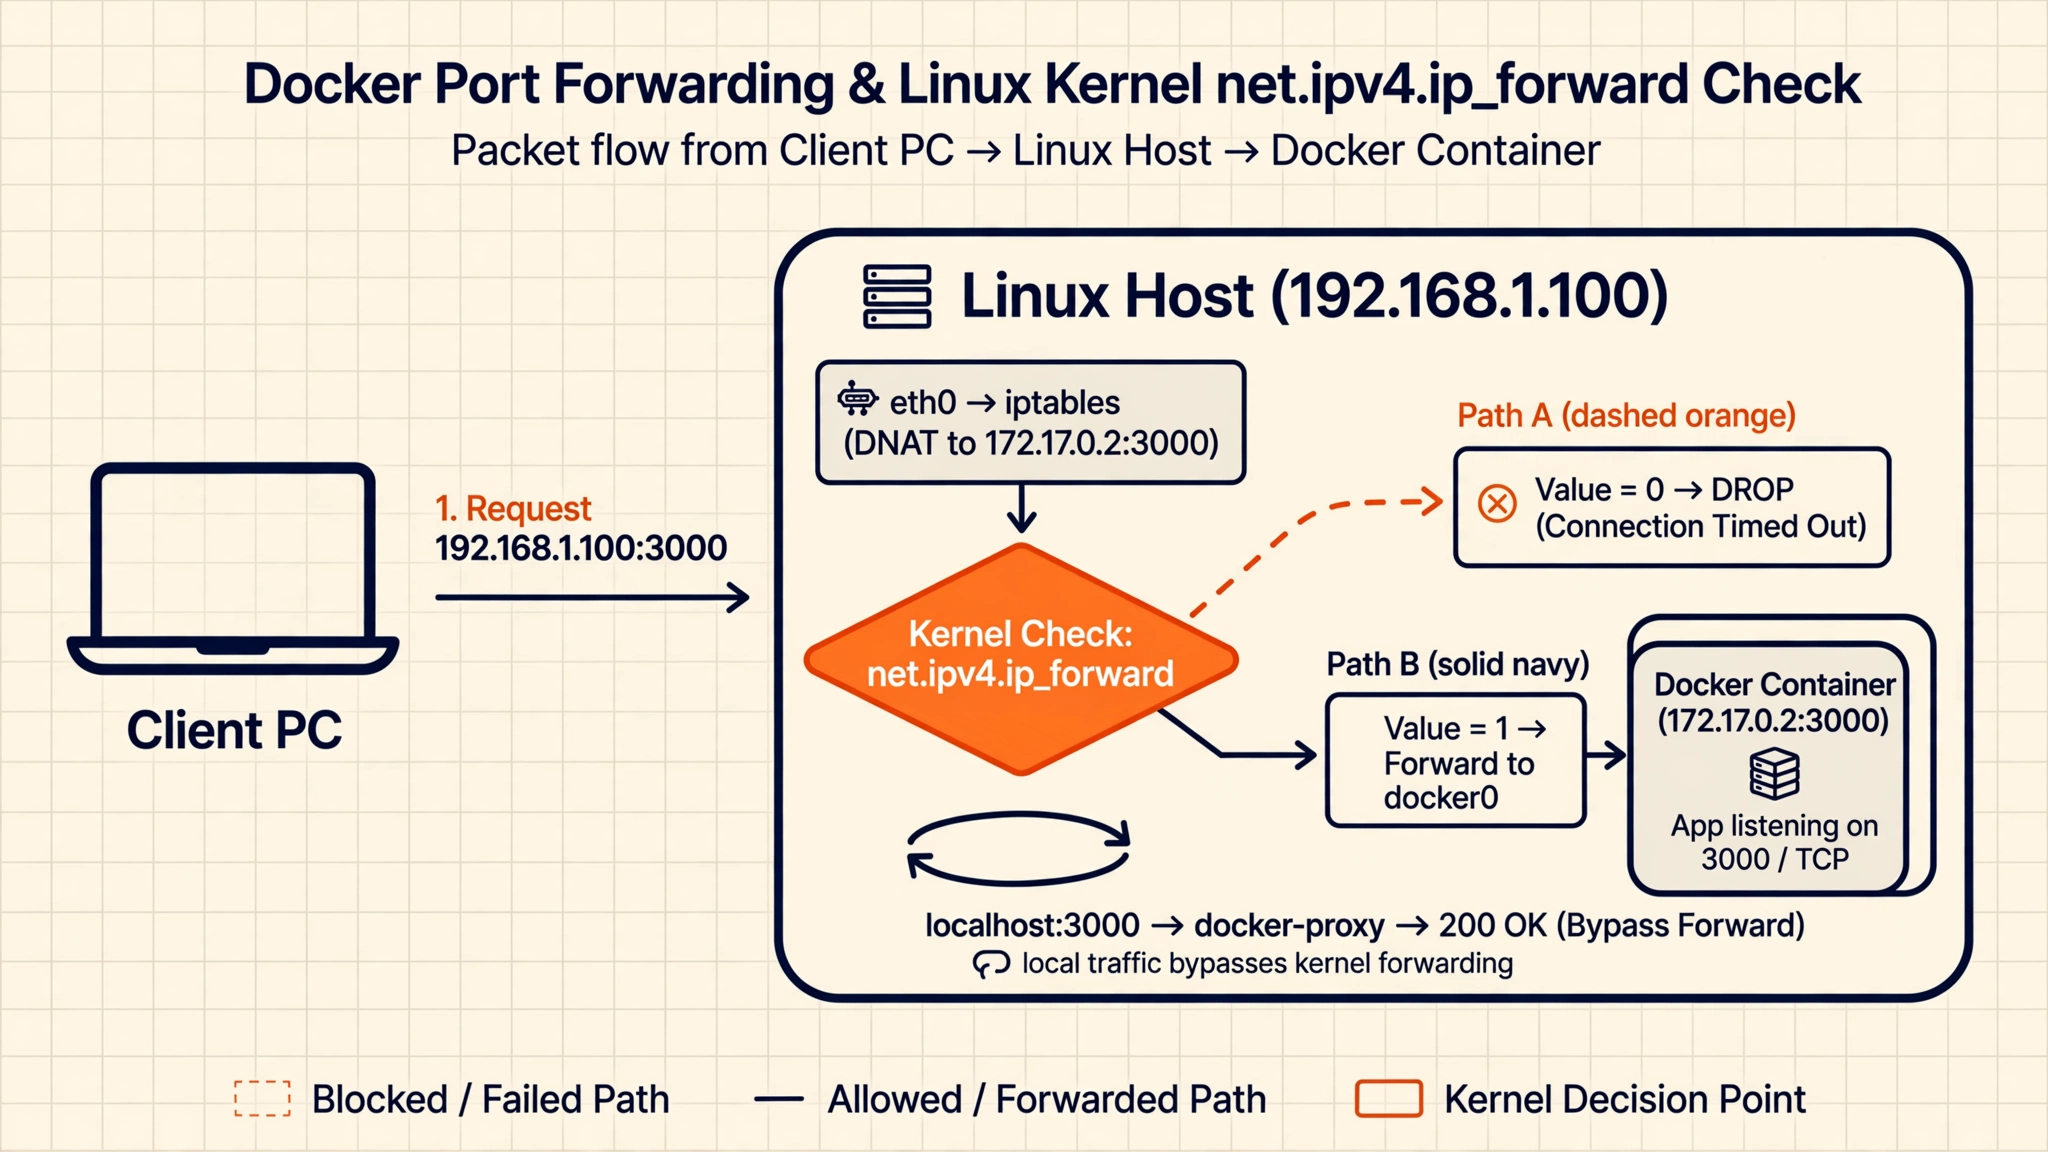
图解:外部流量(左)必须经过内核 ip_forward 检查才能跨网桥进入容器;而本机访问 localhost(下)直接走回环通道由 docker-proxy 转发,从而绕过了内核路由检查。
2. 外部流量根本没走 docker-proxy!
当你在电脑上访问 192.168.1.100:3000 时,数据包刚迈进宿主机的大门(物理网卡 eth0),还没等那个监听 3000 端口的 docker-proxy 反应过来,就被站在门口的保安队长 —— Linux 内核的 iptables(防火墙/网络规则) 给拦下了。
Docker 启动容器时,偷偷塞给保安队长一条指令(DNAT 目标地址转换):”凡是外面找 3000 端口的包裹,直接把收件人地址改写成内部小隔间 172.17.0.2:3000!”
地址改完后,Linux 内核一看:”哟,这包裹不是给宿主机我本人的,是要从大门(eth0)转交到内部走廊(虚拟网桥 docker0)的跨网段包裹啊!”
这时候,内核就会掏出小本本看一眼 net.ipv4.ip_forward 的值:
- 如果是 1:允许代收转交!包裹顺利送进容器。
- 如果是 0:系统规定禁止充当路由器转交包裹!内核二话不说,直接把你的握手请求丢进垃圾桶(DROP)。你在外头苦苦等待回音,最终只能收到一个无情的 TIMED_OUT(连接超时)。
3. 那为什么本机 curl localhost:3000 却能通?
这就是最具有迷惑性的地方了!
当你在服务器本机访问 localhost(即 127.0.0.1)时,走的是本地回环通道(lo),压根没去走外面的物理网卡和跨网段路由规则,而是直接被守在门口的 docker-proxy 进程接手,顺手递进了容器里。
这就造成了”本机测试完全正常、外部访问始终失败”的假象!
四、举一反三:还有哪些场景会踩这个坑?
并不是只有 Docker 才会遇到这个问题。只要你的服务器承担了”把流量从一个网段倒腾到另一个网段”的工作,一旦 ip_forward 被关闭,统统会罢工:
- Kubernetes (K8s) / Podman / containerd:所有容器集群的底层网络(如 Flannel、Calico)全是靠转发活着的,关了它整个节点网络直接瘫痪。
- KVM / QEMU 虚拟机(NAT 模式):在 Linux 里开虚拟机,如果不开转发,里面的虚拟机既上不了网,外面的端口映射也进不去。
- 自建 VPN / 跳板机(如 WireGuard、OpenVPN):连上 VPN 后只能 ping 通服务器自己,但始终无法访问服务器背后的其他内网机器,十有八九也是忘了开转发。
(注:其实 Docker 服务在刚启动时,会自动帮你把 net.ipv4.ip_forward 设为 1。但如果服务器做过安全加固基线脚本、或者后来重启过网络服务 systemd-sysctl,系统就会读取硬盘上的默认配置 0 把它覆盖回去,导致原本好好的容器突然全体失联!)
五、终极解决方案(附防复发命令)
找到了病根,解决起来只需要两步。切记不要只用 sysctl -w 临时修改,否则下次重启服务器或者重启网络服务,坑又会准时出现!
第一步:写入系统配置文件(永久生效)
1 | echo "net.ipv4.ip_forward = 1" >> /etc/sysctl.d/99-docker-forward.conf |
第二步:立即加载配置并验证
1 | sysctl --system |
看到终端稳稳地输出 net.ipv4.ip_forward = 1,这颗隐藏在 Linux 内核里的定时炸弹就算彻底拆除了。
下次再遇到 Docker 端口映射”看得见、摸不着”的情况,别急着重启容器,先敲一行 sysctl net.ipv4.ip_forward 看看吧!
原文作者: liups.com
原文链接: http://liups.com/posts/5b227185/
许可协议: 知识共享署名-非商业性使用 4.0 国际许可协议